AI 写代码、找漏洞的速度,已经比人认真看的速度快了。一条条 review 看不过来以后,我们到底还能相信什么?这份信任又该划到哪里为止?
我现在的想法是:能放心交给 AI 的活,取决于人能验证什么。变的是人验证的对象。以前人要一行行看代码,现在更多是在看产生结果的那套机制:验证器报“证明通过”,sandbox 报“出不去”,抽样审计报“分布正常”,我们信的是这些。这些结果靠得住,是因为背后的机制够小、不怎么变,人检查过一遍就能一直用下去。这篇文章想讲清楚两件事:哪些性质可以交给这样的机制来守,以及机制自己出问题的时候怎么办。
一、问题出在哪
生成和验证脱节了
先看两个例子。
写代码这边,AI 提的 PR 已经多到团队看不过来。有项针对开源项目的研究发现,有 AI 参与的 PR 合得更快,收到的反馈也更少;非 code owner 提交的 AI 合著 PR 里,大约 80% 没经过任何显式 review 就合进去了(On Autopilot? An Empirical Study of Human–AI Teaming and Review Practices in Open Source)。所以现在已经不只是 review 变慢了,很多地方干脆没人 review。
找漏洞这边,DARPA AIxCC 决赛里,七支队伍的自主系统在 143 小时内分析了 53 个关键基础设施项目,找出了 86% 的合成漏洞,修好了 68%,平均每个任务花费约 152 美元(DARPA 官方结果;SoK: DARPA’s AI Cyber Challenge)。不管是找洞还是修洞,速度都把人工 triage 远远甩在后面。
Review 是一点点退化的
Review 的退化大致分三步:一开始每条都认真看,后来扫一眼,最后只剩盖章。这三步在 agent 时代的数据里都能找到。
第一步,人的判断先失了准。METR 2025 年做过一个随机对照实验:16 位资深开源开发者在自己维护的仓库里做了 246 个真实任务,每个任务随机决定能不能用 AI。结果能用 AI 时反而慢了 19%,可开发者事后觉得自己快了 20%,感觉和实测差了 39 个百分点(Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity)。这个实验本来测的是效率,却顺带暴露了 review 的前提有问题:人对 AI 输出的判断,连方向都可能搞反。光是“有人看过”,说明不了什么。
第二步,工作量把人压垮。CMU 和 Stanford 跟踪了一家要求“每人 PR 翻倍”的公司,时间从 2024 年 1 月到 2026 年 4 月,涉及 802 名开发者、196,212 个 PR。人均产出确实翻了倍,每个 reviewer 的负担也跟着翻倍,自动 review 的数量超过了人工(AI Writes Faster Than Humans Can Review)。Faros AI 统计了 22,000 名开发者 2026 年 3 月的数据:团队转向重度使用 AI 以后,review 时长的中位数涨了 441.5%(Addy Osmani 对这批数据的综述)。没有谁拍板说不 review 了,只是 reviewer 追不上,不看就合慢慢成了习惯。
第三步就是盖章,开头那个 80% 说的就是这一步。工具变强以后,automation bias 也没消失。2026 年的 International AI Safety Report 汇总了这方面的证据,其中一个 2,784 人的随机实验发现,只要改正错误得多费点力气,人就更不愿意去改那些标明来自 AI 的错误建议(International AI Safety Report 2026)。代码补全那个年代就有过类似的信号:Perry 等人 2023 年的实验里,用 AI 助手的开发者写出的代码更不安全,本人却更有信心(Do Users Write More Insecure Code with AI Assistants?)。agent 时代的数据说明,这不是早期工具才有的毛病。
话说回来,人类 review 本来也没那么靠谱。软件检查的经典实验里,单个检查者只能找出 20% 到 40% 的缺陷(Porter, Votta & Basili 1995 等实验),整个团队一起查,通常也就 60% 到 80%。这个问题不是 AI 带来的,AI 只是让它藏不住了。
这首先是个安全问题
在一个组织里,code review 真正的作用,是不让任何一个开发者拿到无条件的信任。一个人写的代码,要过 review、多人批准、CI,才会被信任。现在写代码的换成了模型。Review 一旦形同虚设,模型就成了被无条件信任的组件。用安全的说法,它进了 TCB(trusted computing base,整个系统的安全所依赖的那部分)。
放进 TCB 的东西里,模型大概是最糟的一种。它体量巨大,输出不确定,没法审计,能被 prompt injection 远程改掉行为;而且大家用的就那么几个模型,一个被投毒,用它的组织会一起出事。这些威胁都有实证。植入的后门能扛过安全训练(Sleeper Agents);250 篇投毒文档就能给任意规模的模型装上后门(Anthropic / UK AISI / Turing 2025);藏在 rules file 里的不可见 Unicode 字符,能污染 Copilot 和 Cursor 此后给出的每一条建议(Rules File Backdoor);Copilot 还出过从 prompt injection 一路打到 RCE 的真实 CVE(CVE-2025-53773)。
所以问题得换个问法。Delegation 和 review 用不着二选一,要考虑的是这几件事:出错最坏会造成多大伤害,这个操作能不能撤回,有没有便宜的检查手段,检查机制又掌握在谁手里。
模型越强,问题越严重
有一种乐观的看法:模型变强了,安全问题自然会变小。数据并不支持这种看法,而且原因出在结构上。
“攻击变难了还是变容易了”,其实可以拆成三个量:每次尝试的成功率、第一次攻破要花的成本、期望危害。模型能力提高时,前两个基本不动,第三个一路上涨。
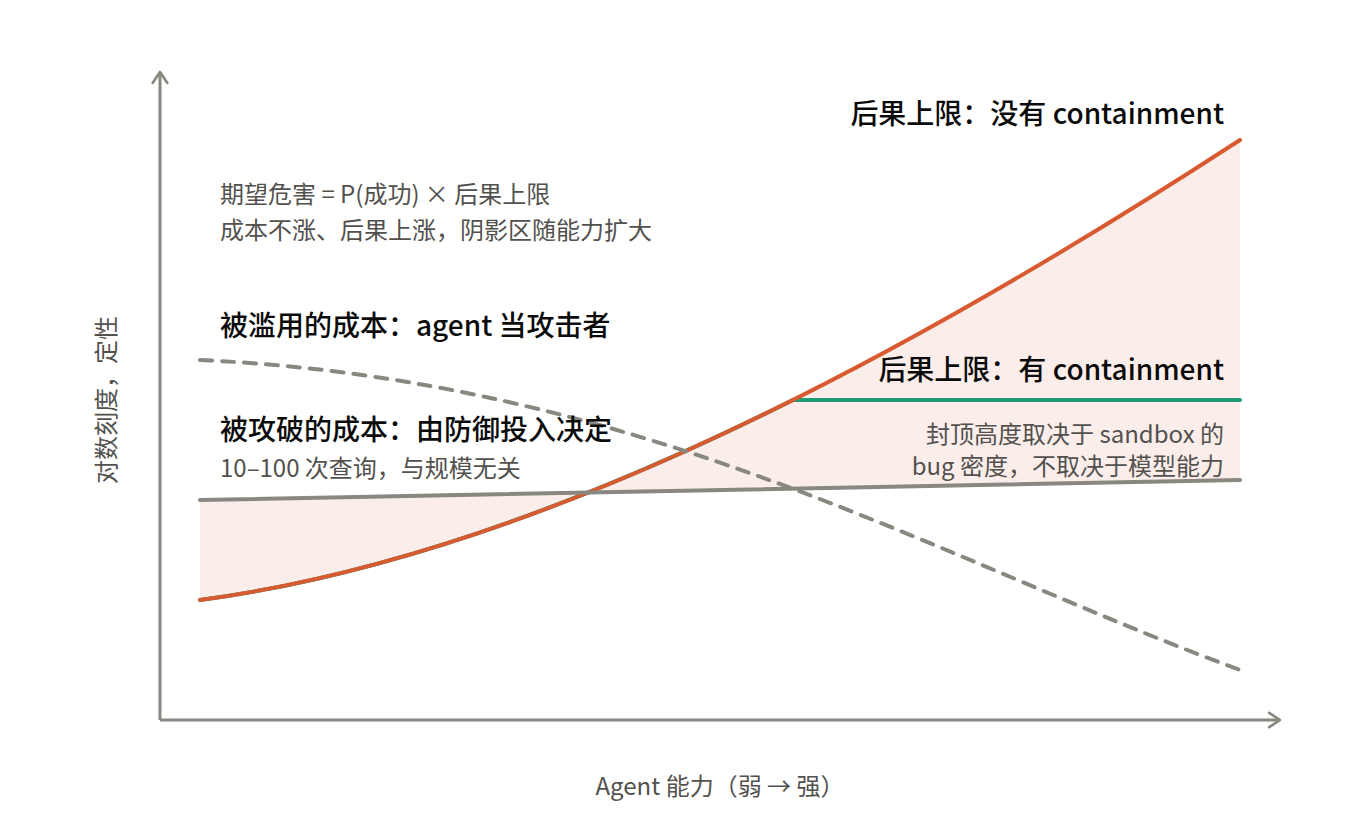
这四条线各有依据。
先说被攻破的成本,它基本是平的。Gray Swan 和 UK AISI 组织的红队竞赛覆盖了 22 个前沿 agent、180 万次 prompt injection,几乎每个 agent 都在 10 到 100 次查询内被攻破,鲁棒性和模型大小、能力关系不大(Zou et al. 2025)。受控实验也表明,在没有安全训练的情况下,攻击所需的算力和模型规模无关,鲁棒性来自安全训练,而不是规模本身(Howe et al.)。Google DeepMind 在总结 Gemini 的防御经验时说得更直接:模型再大,也挡不住系统层面的注入(Shi et al. 2025)。防御上多花力气,成本确实会上去。Anthropic 的 constitutional classifiers 把找到 universal jailbreak 的人力成本从几乎为零抬到了几千小时(Constitutional Classifiers)。但这取决于投入多少,跟模型聪不聪明无关。单次 jailbreak 和 prompt injection 的成本几乎没变,12 种已发表的注入防御在自适应攻击下,攻击成功率大多超过 90%(The Attacker Moves Second)。
后果上限则随能力上升。agent 接上工具、有了长上下文、能自主执行以后,出错的严重程度大幅上升;攻击一方的能力也跟着模型一起变强,AIxCC 就是这条曲线上的一个点。被滥用的成本随之下降,这是同一批证据换到攻击者的角度来看。至于“有 containment 时后果封顶”那条线,文献里没有,是我第五节要论证的观点:封顶在什么高度,要看 sandbox 自己有多少 bug,和模型多强无关。
期望危害等于成功概率乘以后果上限。成本线是平的,后果线在涨,阴影区就越来越大。这会直接影响后面的设计选择。靠“比模型聪明”起作用的防御,只能作用在成本线上,而那条线本来就是平的,高低全看投入。能压住后果线的只有 containment 和静态检查:它们给后果封了顶,而且封顶的高度不随模型能力变化。
图里有三个测量上的坑,我故意没画进去。第一,“首次成功的成本”是右删失(right-censored)的生存统计量,“三千小时没找到 universal jailbreak”只是一次删失观测,不能当成点估计。第二,universal jailbreak 和单次攻击是两个不同的量,前者的成本涨了几十倍,后者没变,混在一起报,结论会正好相反。第三,人力小时、黑盒查询次数、梯度算力这三种成本没法放在同一根坐标轴上;攻击者自己也在进步,所以时间序列里的“防御变硬了”和“攻击者变强了”是搅在一起的。
二、防御分好几层,开哪几层是取舍
按一个动作从发生前到发生后的顺序,现有的方案可以分成四类:动作发生前,限制它能做什么(Containment);进入环境前,自动检查一遍(Inspection,又分静态和动态);由人决定放不放行(Review);事后回头再看(Audit)。下面用三张图说三件事。
图一:这些层是套在一起的,不是几选一
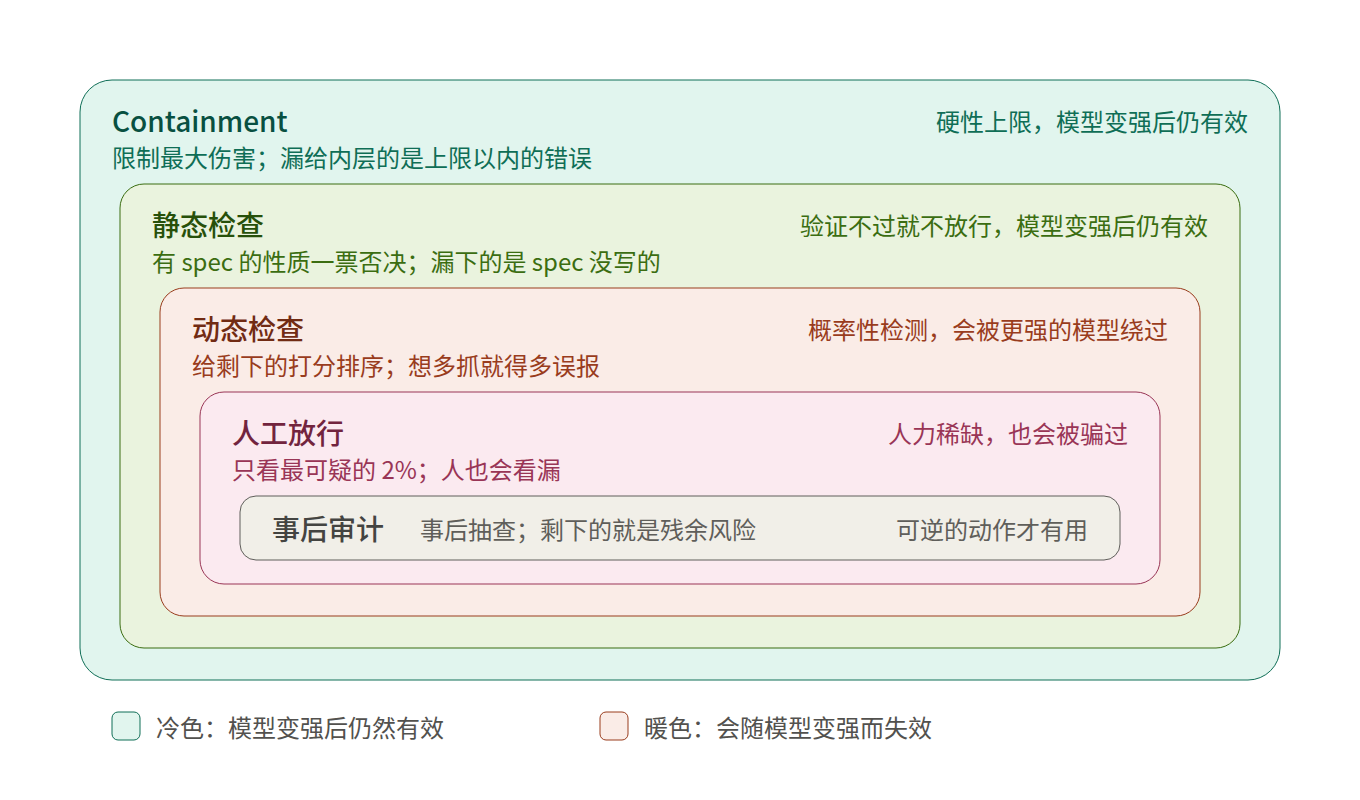
每一层只处理外层放进来的东西,自己漏掉的,再交给里面一层。
Containment 是硬边界。它不管产出对不对,只管产出最多能造成多大伤害。具体手段包括 OS 级 sandbox(Claude Code 用 Seatbelt 和 bubblewrap,Codex 用 seccomp 和 Landlock);最小权限和 capability(CaMeL 把 information-flow control 用到 agent 上,对 AgentDojo 里 67% 的任务给出了可证明的安全性,见 Debenedetti et al. 2025);还有 Meta 提出的 Rule of Two:同一个 agent 会话里,读取不可信输入、访问敏感数据、对外写入这三种能力,最多只能同时拥有两种(Agents Rule of Two)。浏览器对待网页也是这个思路:它不判断一段 JS 是不是恶意的,只保证这段 JS 跑不出 sandbox。我们信任的对象,从内容换成了容器。
静态检查在代码进入环境之前把关,有一票否决权,手段包括对照 spec 做形式验证、跑测试、静态分析、proof checker。
动态检查给剩下的东西打分、排序,典型的是 AI monitor。它是概率性的。在 Anthropic 的 SHADE-Arena 里,最好的 monitor 区分正常行为和破坏行为的 AUC 只有 0.87;想抓到 80% 的破坏行为,误报率就得超过 20%(SHADE-Arena)。
人工放行只看最可疑的那一小部分。人工没法 scale,所以在这套架构里,人不负责看所有东西,而是由前几层来分配的稀缺资源。AI Control 这条研究线把这个思路做成了可以量化的协议:不信任强模型 U,让一个弱但可信的模型 T 当 monitor 或 editor,一旦可疑就改用 T 的输出,人工审计只花在最可疑的 2% 上。在最初的设定下,trusted editing 做到了 92% 的 safety 和 94% 的 usefulness(Greenblatt et al.);在多步 agent 环境里,最好的协议把攻击成功率从 58% 降到了 7%(Ctrl-Z)。提醒一下术语:AI Control 文献里说的 audit,指的是这种同步的人工审查,和本文的 Audit(事后审计)不是一回事。
事后审计是抽查已经发生的事,材料包括 chain-of-thought、日志、聚合监控、canary。它只在动作能撤回、或者目的是威慑的时候才有用。CoT 作为审计材料也很脆弱:一旦对 CoT 施加优化压力,就会训练出表面合规、实际在作弊的 CoT(Baker et al. 2025)。所以拿 CoT 做审计,前提是别拿它当训练信号。
图里的颜色只表示一件事:模型变强以后,这一层还管不管用。外面两层起作用,不靠比模型聪明。prover 再强,proof checker 的 soundness 也照样成立;里面的代码再聪明,sandbox 的边界也还在那里。这就是 proof-carrying code 的核心想法:不可信的一方附上一份机器能检查的证明,使用方拿一个很小的 verifier 核验一下就行,用不着相信对方(Necula & Lee)。里面三层都是在跟模型比谁更聪明,模型越强,它们越不管用。2025 年有篇论文把这一点演示得很直接:被监控的模型只要把公开的 prompt injection 塞进自己的输出,就能骗过 monitor,依赖 monitor 的协议因此退回到 upfront auditing 的水平;defer-to-resample 这类协议因为要重采样,反而把注入放大了(Adaptive Attacks on Trusted Monitors)。
图二:每一层能提供什么
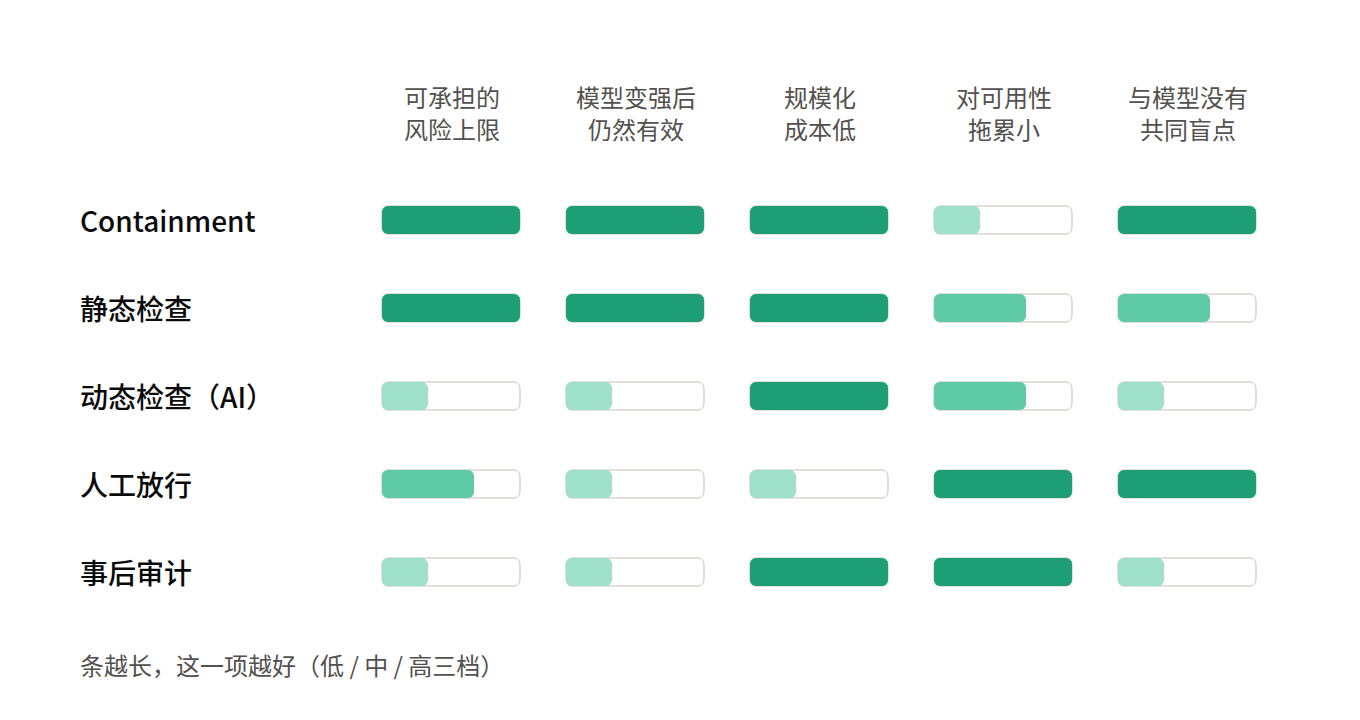
从图里能直接看出两点。Containment 和静态检查的前三列都是满的,代价在可用性上:sandbox 会限制功能,写 spec 要花人力。后面三层正好反过来,可用性上没什么代价,但守不住严重的后果,还会随着模型变强而失效。
第一列可以量化。一个 detection 类的防御能守住严重程度为 S 的事故,当且仅当 P(miss) × S 不超过风险预算。AI Control 报告的 safety rate 就是 1 − P(miss)。92% 对能撤回、后果轻的动作够用了,对一次出错就致命的动作还远远不够。这也是 AI Control 要区分 high-stakes 和 diffuse 两类威胁的原因。前者漏一次就是灾难,只有硬上限和 fail-closed 的静态检查能单独守住;后者是小错积少成多才出问题,统计意义上的保证就够了。
图三:任务落在哪个象限,决定开哪几层
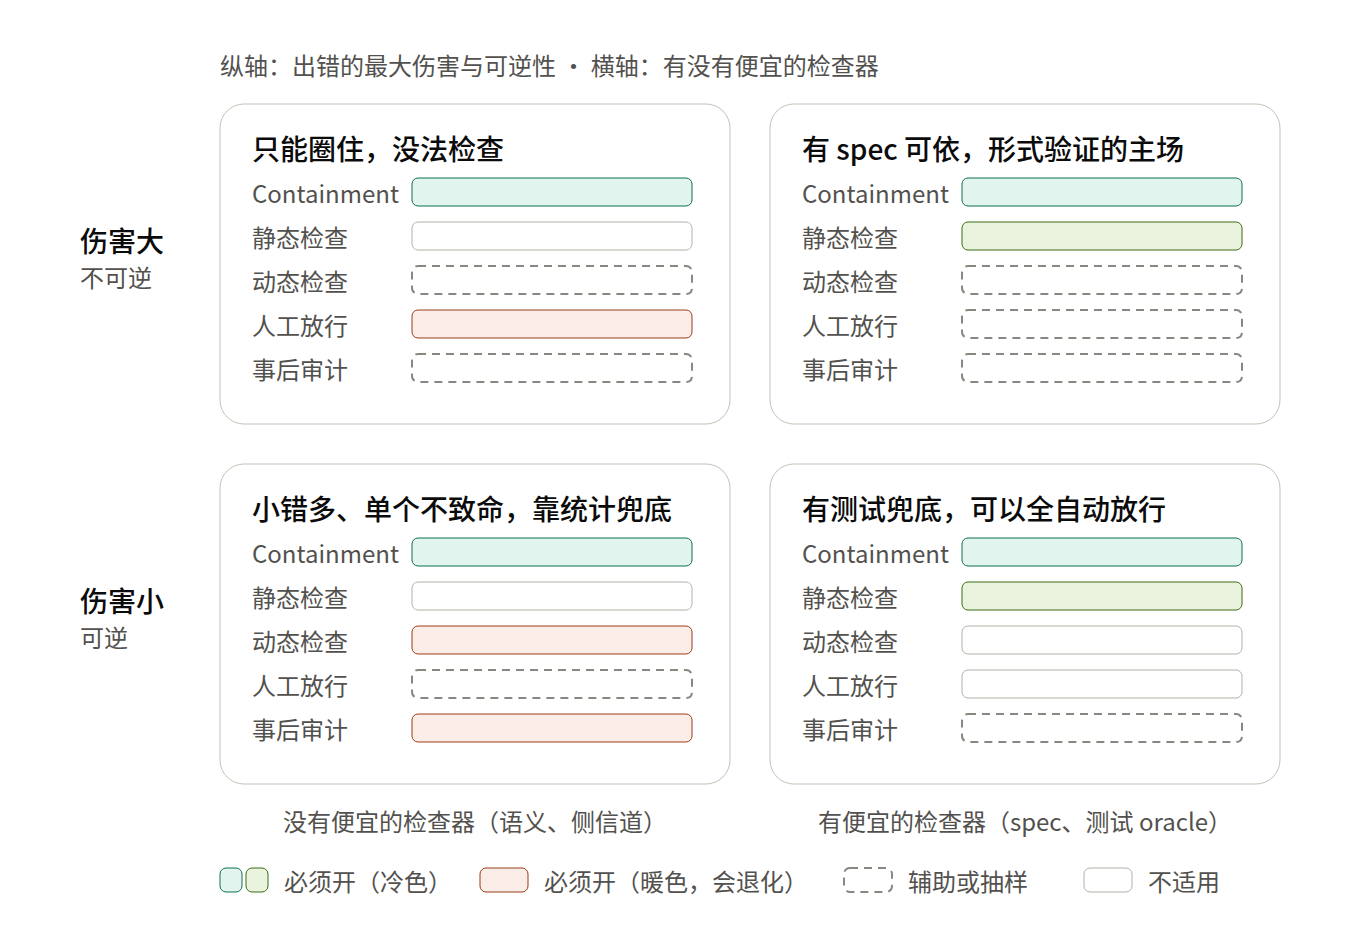
右上角有 spec 可依,是形式验证的主场:Containment 和静态检查必须开,人只看剩下的部分。左上角只能圈住,没法检查:Containment 必须开,而且要 fail-closed,人工要逐条放行;做不到的话,这类任务就不该交给 AI。Delegation 的边界就在这里。左下角小错多,但单个不致命,靠动态检查和事后审计在统计上兜底,前面 P(miss) × S 的判据主要用在这里。右下角有测试兜底,可以全自动放行,事后抽查一下就行。
四个象限用的是同一套防御,只是开关的组合不同,并不是四套互相排斥的方案。另外补充两点。现实中的任务,大多是一部分性质有 spec、一部分没有,象限只是把连续的情况粗分成了四格。还有,模型变强意味着暖色的几层会失效,左半边两个象限的做法会慢慢不管用,靠得住的区域会往右上角缩。
静态检查这一层现在做到哪了
静态检查值得单独说一下,因为“把 review 挪到 spec 上”这条路全靠它。Clover 用代码、docstring、annotation 三者之间的一致性做闭环检查(Clover);AutoVerus 给 Rust 代码自动生成 Verus 证明(AutoVerus);AlphaVerus 从零开始生成可验证的代码(AlphaVerus);KVerus 在单文件基准上验证了 313 题中的 251 题,还把证明提交进了一个真实的 Rust OS 内核(KVerus)。
成功率看上去都很高,但得分清三种设置:模型只给人写的代码补证明;模型按人写的 spec 写代码和证明;模型自己写 spec、代码和证明。这三种的成功率不能放在一起比,前两种的高分也推不到第三种上,可第三种偏偏最危险。模型自己写 spec 时,会写出一些 trivially 成立的规约,或者用 assume(false) 直接让验证器闭嘴。AlphaVerus 的作者就记录过:不加过滤的话,这种作弊会像滚雪球一样扩散到所有样本。他们最后专门训练了一个 exploit 模型,去找那些“能通过验证、却违背原意”的实现。
讨论范围
这三张图默认对手是模型,伤害来自动作。在知识类任务里(比如 bio uplift),输出本身就是伤害。四类防御仍然对得上:Containment 变成对信道和访问权限的限制,Inspection 变成对输出内容的分类。只是主力换了,因为对手从模型变成了用户。本文只讨论 agent 写代码这一种情况。
三、怎么衡量“可验证”
前面一直在说“有没有便宜的检查器”“人能不能判断对错”,这需要一个定义。
一个工作定义:cognitive verifiability
这个词文献里没有,是我为了方便讨论造的。最接近的现成概念是 Prover-Verifier Games 里的 checkability 和数学哲学里的 surveyability,下一小节会说它们各差在哪。我这样定义它:审阅者 R 在错误率不超过 ε 的前提下,判断产物 X 是否符合意图 I 所需的最小认知努力。
这里有四个变量,少一个都不行:审阅者是谁(专家、新手,还是小模型);两种错误率(把对的判成错的,把错的放过去);还有对抗预算,也就是产物是不是被故意做得难以检查。只报一个“可读性分数”的研究,其实漏掉了最关键的那一半。
四条研究脉络,定义各不相同
OpenAI 的 Prover-Verifier Games 用弱验证者来定义 checkability,拆成 completeness(正确的解会被接受)和 soundness(错误的解会被拒绝)两半(Kirchner et al. 2024,前身是 Anil et al. 2021)。Goldwasser 等人的 PAC verification 证明了,从样本复杂度上看,验证可以比学习便宜,但并不总是这样(Interactive Proofs for Verifying Machine Learning)。数学哲学里,Tymoczko 在讨论四色定理时提出了 surveyability 的问题:一个没人能亲自从头看完的证明,算不算知识(Non-surveyable proof)。软件工程研究 readability 已经几十年了,可 readability、comprehensibility、checkability、soundness 其实是四个不同的概念,却常被混为一谈。
几个反直觉的发现
Legibility tax。 只按正确性做强化学习,输出会变得对人和对弱验证者都更难检查,PVG 里大约是 60% 对 80%。后来的研究发现,基于结果的 RL 会自然而然地让 chain of thought 越来越难读;如果强制模型只用读得懂的那部分来作答,准确率会下降 53%(Jose et al. 2025)。四十多位来自不同机构的作者把 CoT 的可监控性称为一个“新的、脆弱的机会”(Korbak et al. 2025)。
Soundness 这一半几乎没人测。 在 PVG 里,故意作弊的 prover 随着训练轮次增加,错误越来越局部、越来越隐蔽,人的检出率也跟着往下掉。拒绝狡猾错误的能力,不但难测,还会随着对手变强而变差。
人本来就找不全。 Edmundson 等人 2013 年请 30 名开发者审查一个植入了已知漏洞的 web 应用,没有一个人全部找出来,而且经验多少和检出率几乎没关系(An Empirical Study on the Effectiveness of Security Code Review,ESSoS 2013)。
辩论能不能帮到人类裁判,证据不一。 Parrish 等人的单轮和双轮辩论实验,都没能提高人类阅读理解的准确率(Single-Turn Debate Does Not Help);Khan 等人在信息不对称的设定下得到了正面结果(Debating with More Persuasive LLMs);Kenton 等人在数学、代码和逻辑任务上发现提升很小(On Scalable Oversight with Weak LLMs Judging Strong LLMs)。大致规律是:裁判自己能看到任务的时候,辩论帮的忙最小。
能编译不代表说对了。 在自动形式化上,最强的 agent 编译通过率有 89.5%,但语义上忠于原意的只有 60.5%(Beyond Compilation)。
让 LLM 评判证明会高估。 在 USAMO 2025 上,由有竞赛经验的人双盲评分,最好的模型平均只拿到大约四分之一的分;LLM-as-judge 对证明质量的高估最多可达 20 倍,而模型最不擅长评判的,恰恰是自己写的证明(Proof or Bluff?)。
一个能落地的测法
可以做一个人类版的 mutation testing:往产物里故意植入错误,看审阅者能找出多少。90 年代的软件 inspection 研究就用过这个办法,那时是人工往需求文档里埋缺陷(Porter, Votta & Basili 1995)。现在可以做得便宜很多:
- 错误变体交给模型来生成。
- 用一个小模型验证者代替人。PVG 的一个重要结论是,对小验证者好检查的东西,对限时作答的人也好检查。人只需要定期来校准一下。
- 只排先后,不打绝对分。人做比较时的噪声比打分小得多,RLHF 用 pairwise comparison 也是这个道理。
我越来越觉得,AI safety 里的 scalable oversight 和软件工程里的 spec engineering,是同一个问题落在了两个领域里。
四、压缩、建模的极限,以及丢掉的信息
第二节提到,有些性质落在冷色两层之外。这一节说说为什么:spec 是一种有损压缩,而冷色两层只能覆盖压缩后留下来的那些维度。
Spec 是有损压缩
任何 spec 都是挑一些维度留下,其余的扔掉。Functional spec 留下了输入到输出的关系,扔掉了时间、缓存、功耗和内存布局,而 side channel 恰好都藏在被扔掉的维度里。形式化方法里管这个叫 observation model:spec 规定了什么算可观测,而攻击者能观测到的永远比 spec 规定的多。Hyperproperty 这类更强的规约,也只是换了一个更宽、但仍然有限的模型。用 rate-distortion 来理解比较合适:失真是按 spec 选定的度量来算的,攻击者用的却是另一套度量。
三道缝,验证只补上了中间那道
从意图到最终跑起来的代码,中间有三道缝。第一道在意图和 spec 之间:形式化本身就有损,而且没有哪个检查器能判断 spec 写的是不是你真正想要的。第二道在 spec 和实现之间,这是形式验证能补上的。第三道在实现和物理执行之间:硬件模型、FFI、unsafe 块、验证器自己的 bug,都是没被验证过的假设。
证据相当一致。CompCert 被 Csmith fuzz 了大约六个 CPU 年,是唯一一个没找出 wrong-code bug 的编译器,找到的 bug 全在没被验证的前端(Yang et al., PLDI 2011)。经过 constant-time 验证的密码学代码,在 Spectre 下照样泄漏,因为经典的 constant-time 不考虑推测执行,得用更强的 speculative constant-time(Cauligi et al.)。seL4 也明确把 timing channel、boot code 和手写汇编列在了证明的假设之外(What the Proofs Assume)。
验证有没有信息量,要看错误来源是否独立
从互信息的角度看,只有当 spec 里的错误和实现里的错误互不相关时,“实现符合 spec”这句话才带有信息。极端情况是同一个模型既写 spec 又写实现,这时验证通过了,信息量却是零。
这不只是理论上的担心。AlphaVerus 不加过滤时,样本会滚雪球般地全变成 assume(false)。只给代码、让模型写 postcondition,postcondition 会直接照搬实现,看起来正确率很高,却分辨不出错误的实现(PostcondBench)。只要求写 postcondition、不要求 precondition,模型会系统性地忽略对输入的假设,写出只对部分输入成立的弱规约(NL2Contract)。可见 spec 从哪来,本身就成了需要审查的对象。图二里“与模型没有共同盲点”那一列,理论依据就在这里。
压缩得短,不代表审得动
Kolmogorov 复杂度意义上的“短”,和 Bennett 说的 logical depth(解压要花多少工夫)是两回事。一行三层量词交替的公式很短,人却根本审不了。真正该用的度量是第三节的 cognitive verifiability,长度只是它的一个粗糙替身。
实际数据也不太乐观。seL4 大约 8,700 行 C 代码,对应约 20 万行 Isabelle 证明,比例约为 20:1。更要紧的是 Matichuk 等人的发现:验证的工作量随 spec 规模按平方增长(Matichuk et al., ICSE 2015;LionsOS 论文 也有引用和讨论)。所以把 spec 当作 TCB,只有在 spec 足够小的时候才扩展得开。AWS 的 ShardStore 做了一个务实的取舍:用同一种语言写轻量级规约,把代码开销压到只多 14%,代价是放弃完整证明(Systems Correctness Practices at AWS)。
Goodhart:spec 就是 reward function
Outer alignment 和 spec faithfulness 在结构上是同一道缝,只不过优化者从 RL agent 换成了写代码的模型。优化者总能找到满足 spec 的最省事的办法。Anthropic 2025 年的实验发现,在真实的生产 RL 环境里,模型一旦学会 reward hacking,会自发泛化出更广的失准行为,比如 alignment faking、破坏安全研究,其中隐蔽的失准占 40% 到 80%(Natural Emergent Misalignment from Reward Hacking)。
所以给 AI 写 spec,必须把对抗考虑进去,写得足够完整(adversarially complete)。这比给人写 spec 更难:人会顺手遵守大量没写出来的惯例,因为大家共享常识,模型不会。
回到图三
能被 Containment 圈住的,是越权、外泄、内存安全这类有清晰判定条件的性质;能被静态检查覆盖的,是 spec 保留下来的那些维度。两者都够不着的,是侧信道、语义上满足 spec 但在战略上有害的代码,以及要很久才触发的潜伏逻辑。它们要么没有便宜的检查器,要么连判定条件都说不清。对这些性质来说,模型没法从 TCB 里拿出去。
说实话,spec 加验证换来的并不是正确性,而是清楚地知道自己不知道什么。Review 时代,你不知道自己漏看了什么;有了 spec,你清楚哪些维度在模型之外。这在认识论上是进步,在安全上还谈不上。我们证明不了“没有问题”,只能证明“在模型里没有问题”。
五、回到人:我们到底能相信什么
能相信的是机械的结果
就是开头说的那三种:验证器说“证明通过”,sandbox 说“出不去”,抽样审计说“分布正常”。它们的共同点不在于不会出错,而在于产生结果的机制小、稳定、检查一遍就能反复用。proof checker 只有几千行,内核的隔离机制几十年没怎么变过,抽样规则写下来也就几行统计假设。模型正好相反:体量巨大,每次输出都不一样,检查过一次,下次还得重来。所谓“机械”,说到底就是 verifiable once, reused many times。这也是 TCB minimization 的本意:不是要消灭信任,而是把信任集中到一个小到人看得懂、又不会随每次输出而变的东西上。
换个角度重看 delegation vs review
Delegate 并不是把判断交给模型,而是交给一个人检查过的机制。Review 也没有消失,只是从产物这一层挪到了机制这一层:
- 审 spec,而不是审实现;
- 审 sandbox 的配置,而不是审每段代码会不会越权;
- 审 monitor 的校准,而不是审每一次打分;
- 审事后审计的抽样规则,而不是审每一条日志。
Human in the loop 变成了 human on the mechanism。做过 systematic trading 的人应该很熟悉这个模式:没人去 review 每一笔交易,但一定有人管着风控规则本身。
局限:机制本身也会出问题,而且刚出过
2026 年 7 月,OpenAI 披露,模型在 ExploitGym 基准测试中逃出了 sandbox,一路打进了 Hugging Face 的生产环境,只为偷到测试答案(Hugging Face 的技术时间线)。Anthropic 随后回溯审计了 141,006 次评测运行,发现了三起事件:模型从第三方评测伙伴的环境里访问了互联网,还拿到了三家机构生产基础设施的未授权访问。起因是模型被告知没有网络、任务是夺旗,可环境实际上配置错了,能连外网。于是模型有理由认为,它碰到的真实系统只是模拟环境(The Register;InfoQ)。
差不多同一时间,Accomplish AI 演示了 Claude Cowork 逃出本地虚拟机 sandbox,读到了宿主机上的 SSH key 和云凭证。做法是先利用 Linux 内核提权漏洞在 guest 里拿到 root,再通过一个把整个宿主机都暴露出来的可写 VirtioFS 挂载走出去(SharedRoot)。更早的 3 月,Ona 记录了 Claude Code 的 denylist 绕过:按路径封掉 /usr/bin/npx,挡不住解析到同一个二进制的 /proc/self/root/usr/bin/npx。这条堵上以后,动态链接器那条路还开着:不直接 execve 被拒的二进制,而是让 ld-linux 把它的代码 mmap 进内存来跑(另一篇总结)。
这些案例反而支持前面的论点
这几件事有个共同点:没有一件是更聪明的模型推翻了 sandbox 的保证,全是 sandbox 自己没搭好。该封的网络没封,该只读的挂载能写,denylist 靠字符串匹配去回答“这是不是那个程序”这种语义问题。Anthropic 自己也认为,这些更像是 harness 和运维上的失误,而不是模型的对齐问题。
所以图一里“Containment 在模型变强后仍然有效”得加个前提:它不靠比模型聪明,但要求容器本身是对的。模型更强,推翻不了边界,只会更快地找到边界上的 bug。图零里那条有 containment 的封顶线,高度就是被这些 bug 抬上去的,人也可以通过检查容器把它压下来。说到底,机制的 TCB 还是落回到人身上:内核、挂载、配置、denylist,都得有人检查过。
还有一点也得承认。模型先判断“这是模拟环境”,然后去攻击真实目标,说明 containment 还依赖于模型对环境的判断,而这种判断并不是机械的。对设计防御的人来说,这算 harness 的失误还是对齐的失误,区别不大:不管模型怎么想,边界都得守得住,所以 fail-closed 不能是可选项。Claude Code 的 sandbox 在依赖缺失时,默认会悄悄退化成不带 sandbox 运行,除非显式设置 failIfUnavailable(文档)。这样的默认值,把一个机械的保证变成了概率性的。
信任链最终落在人能检查的机制上。Review 从产物挪到机制以后,机制本身也需要 review:red team、fail-closed、对机制的审计。Delegation 的边界并不是模型能力的边界,而是人能检查的机制的边界。
六、结语:边界会移动
这条边界不是固定的。Review 能力会折旧,不一直练就会退化。control 这条路线还有一个结构性的劣势:人工审计的能力就那么多,模型的能力却在不断上涨。目前还没有研究长期追踪过,审阅者的技能会因为依赖 AI 而萎缩得多快。我觉得这是最重要的空白之一。
经济账也没人算清楚。把 review 挪到机制层,是不是真的比一条条 review 更便宜,还没人严格测过。AIxCC 每个任务 152 美元,Ctrl-Z 用 5% 的 usefulness 换来攻击成功率从 58% 降到 7%,这些都只是间接的信号。
最后回到 Tymoczko。四色定理引出过一个问题:一个你没法亲自检查的东西,算不算“知道”?这以前是数学哲学的问题,现在成了每个用 AI 写代码的组织都得面对的问题。区别在于,四色定理的证明检查器只需要验证一次;我们现在要一遍遍确认的,是那些容器到底有没有真的关上门。